
/ de / work / trustworthy-rag-patterns
Eine RAG-Demo braucht 20 Zeilen. Ein vertrauenswürdiges KI-System braucht 20 Entscheidungen.
Eine interaktive Pattern-Karte für gesteuerte GenAI-Systeme
→ Zentrale Erkenntnis: Macht aus einer Liste von KI-Tools eine prüfbare Architektur mit expliziten Kontrollen, Evaluations-Gates und Betriebsgrenzen.
- Kontext
- Unabhängiger Wissensbeitrag
- Beitrag
- Autor & Referenzarchitekt
- Zeitraum
- 2026
- Status
- veröffentlicht
- 20 Architekturentscheidungen
- 5 Kontrollebenen
- 0 Arbeitgeber-Claims
Die provokante Version
Eine RAG-Demo ist oft eine saubere Kette: teilen → einbetten → suchen → generieren. Sie passt in ein Notebook und kann nach einem Nachmittag überzeugend aussehen.
Ein vertrauenswürdiges KI-System ist anders. Die schwierige Arbeit ist nicht der Modellaufruf. Entscheidend ist, was das Modell sehen darf, welche Tools es nutzen kann, wie Aussagen getestet werden und was bei Qualitäts-, Latenz- oder Kostendrift geschieht.
Dieser Beitrag beschreibt ein unabhängiges Architekturmuster. Er beschreibt keinen Arbeitgeber, Kunden, kein internes System und keinen realen Unternehmenseinsatz.
Die fünf Kontrollebenen
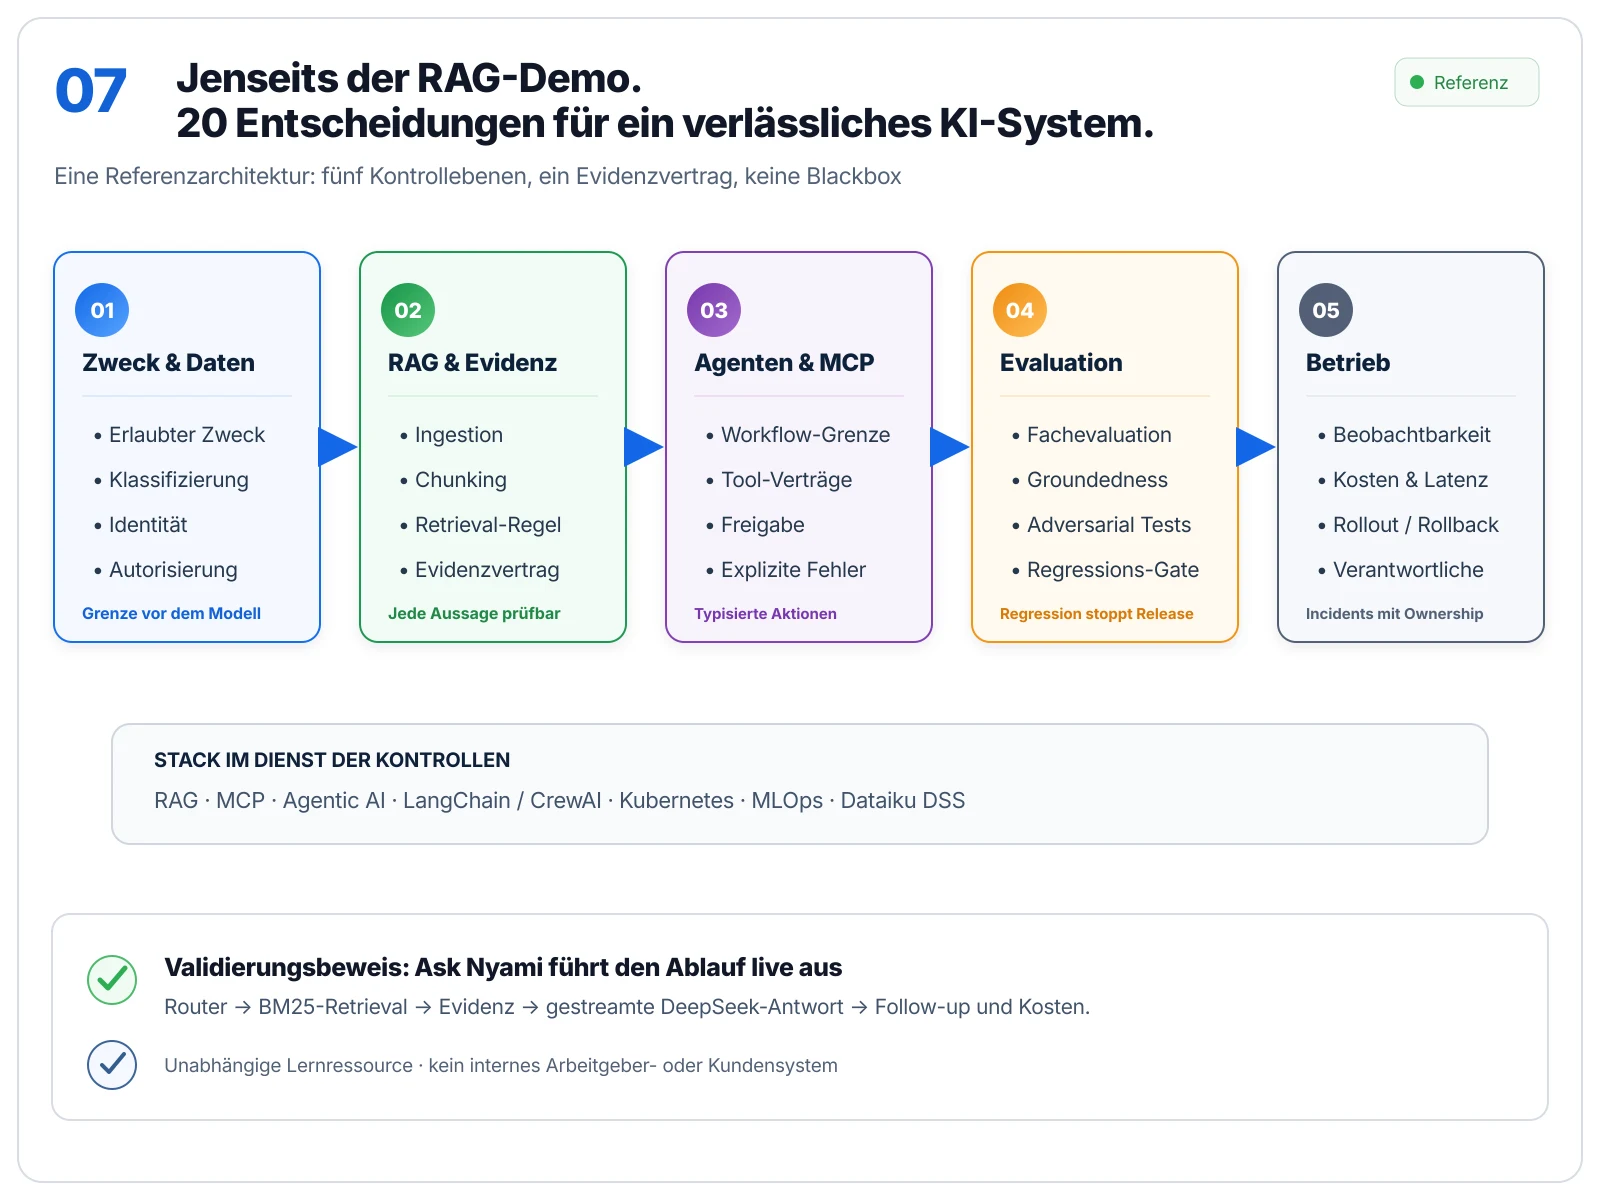
Die zwanzig Entscheidungen werden übersichtlicher, wenn sie fünf Kontrollebenen zugeordnet werden.
1. Zweck und Datengrenze
- Zweck — welche Entscheidung oder Aufgabe darf das System unterstützen?
- Datenklassifizierung — welche Quellen sind öffentlich, intern, vertraulich oder verboten?
- Identität — wer fragt und wie stark muss die Authentifizierung sein?
- Autorisierung — welche Dokumente darf diese Identität vor jedem Modellaufruf abrufen?
2. Retrieval und Evidenz
- Ingestion-Vertrag — wer verantwortet Aktualität, Löschung und Quellenqualität?
- Chunking-Strategie — welche semantischen Einheiten bewahren Bedeutung und Zugriffsmetadaten?
- Retrieval-Policy — lexikalisch, vektorbasiert oder hybrid; Filter vor dem Ranking, niemals danach.
- Evidenz-Vertrag — jede wichtige Aussage verweist auf eine prüfbare Quelle.
3. Agenten und Tools
- Workflow-Grenze — deterministischer Code bei bekanntem Pfad; ein Agent nur bei echter Auswahl.
- Tool-Vertrag — MCP kann typisierte Fähigkeiten bereitstellen, benötigt aber weiterhin enge Ein-/Ausgaben und Berechtigungen.
- Freigabegrenze — folgenreiche Aktionen brauchen deterministische Validierung oder menschliche Freigabe.
- Fehlersemantik — Timeouts, Teilergebnisse und Retries bleiben sichtbar statt vom Modell still improvisiert zu werden.
4. Evaluation und Release
- Aufgabenspezifisches Eval-Set — repräsentative Fragen, schwierige Negative und policy-sensitive Fälle.
- Groundedness-Gate — Evidenzqualität wird getrennt von Schreibqualität gemessen.
- Adversariale Tests — Prompt Injection, Datenabfluss und Tool-Missbrauch sind Release-Kriterien.
- Regressions-Policy — Änderungen an Modell, Prompt oder Index bleiben innerhalb definierter Schwellen.
5. Betrieb und Verantwortung
- Observability — Retrieval, Tool-Aufrufe, Ausgabe, Latenz und Kosten ohne Geheimnisse protokollieren.
- Budget- und Latenz-SLOs — Caps vor den Kosten prüfen und bei Limits sauber degradieren.
- Rollout und Rollback — Prompts, Indizes und Policies versionieren; Canary und schnelle Rückkehr ermöglichen.
- Menschliche Verantwortung — Ownership, Eskalation, Aufbewahrung und Incident Response vor dem Start festlegen.
Wo die genannten Technologien einzuordnen sind
- RAG verankert Antworten in kontrollierter Evidenz.
- Agentic AI behandelt begrenzte Entscheidungen und zerlegt unsichere Aufgaben.
- MCP bietet typisierten Tool-Zugriff, aber nicht automatisch Autorisierung.
- LangChain und CrewAI sind Orchestrierungsoptionen, nicht die Architektur.
- Kubernetes kann Isolation, Rollout und Betriebskontrollen bieten, wenn diese Komplexität gerechtfertigt ist.
- MLOps / LLMOps umfasst Evaluation, Versionierung, Monitoring, Incident Response und Rollback.
- Dataiku DSS ist eine mögliche gesteuerte Data-Science-Plattform innerhalb einer größeren Kontrollumgebung.
Drei Anti-Patterns
„Wir haben Zitate ergänzt.“ Zitate helfen nicht, wenn das Retrieval Dokumentberechtigungen ignoriert hat.
„Der Agent hat einen MCP-Server.“ Ein Protokoll ist kein Sicherheitsmodell; Tool-Rechte und Freigabegrenzen bleiben nötig.
„Die Antwort sah in der Demo gut aus.“ Eine gute Demo-Antwort ist eine Anekdote. Ein Release-Gate braucht Dataset, Schwellen und Regressionshistorie.
Praktische Schlussfolgerung
Beginne nicht mit der Frage nach dem Framework. Mache zuerst die zwanzig Entscheidungen explizit. Wähle dann den kleinsten Stack, der sie durchsetzen und die Wirksamkeit der Kontrollen belegen kann.
Das Pattern Lab in Ask Nyami macht den Beitrag interaktiv: Kontrollebene wählen, vier Entscheidungen prüfen und Trade-offs hinterfragen.
Transparenz
Dieser Beitrag teilt allgemeines technisches Wissen für Bildung und Community. Er enthält keine Arbeitgeber- oder Kundenidentität, keinen internen Systemnamen, keine proprietären Details und keine vertraulichen Metriken. Er behauptet nicht, dass diese Referenzarchitektur von einem Unternehmen eingesetzt wird.
🚧 V-next — bereits in Arbeit
Dieses System liefert kontinuierlich — die nächsten Stufen sind schon auf der Werkbank. Schau wieder vorbei oder frag den Agenten nach dem Stand.
- Dies ist ein Referenzmuster und keine Behauptung über einen Unternehmenseinsatz.
- Kontrollen müssen an Datenklassifizierung, Rechtsraum und Risikoprofil des jeweiligen Kontexts angepasst werden.
- Framework-Namen sind Implementierungsoptionen und kein Ersatz für Architekturentscheidungen.